Entrevistas
«La infraestructura de IA es una inversión estratégica a largo plazo»
Cyril Laurie
Director técnico de preventa para EMEA
AMD

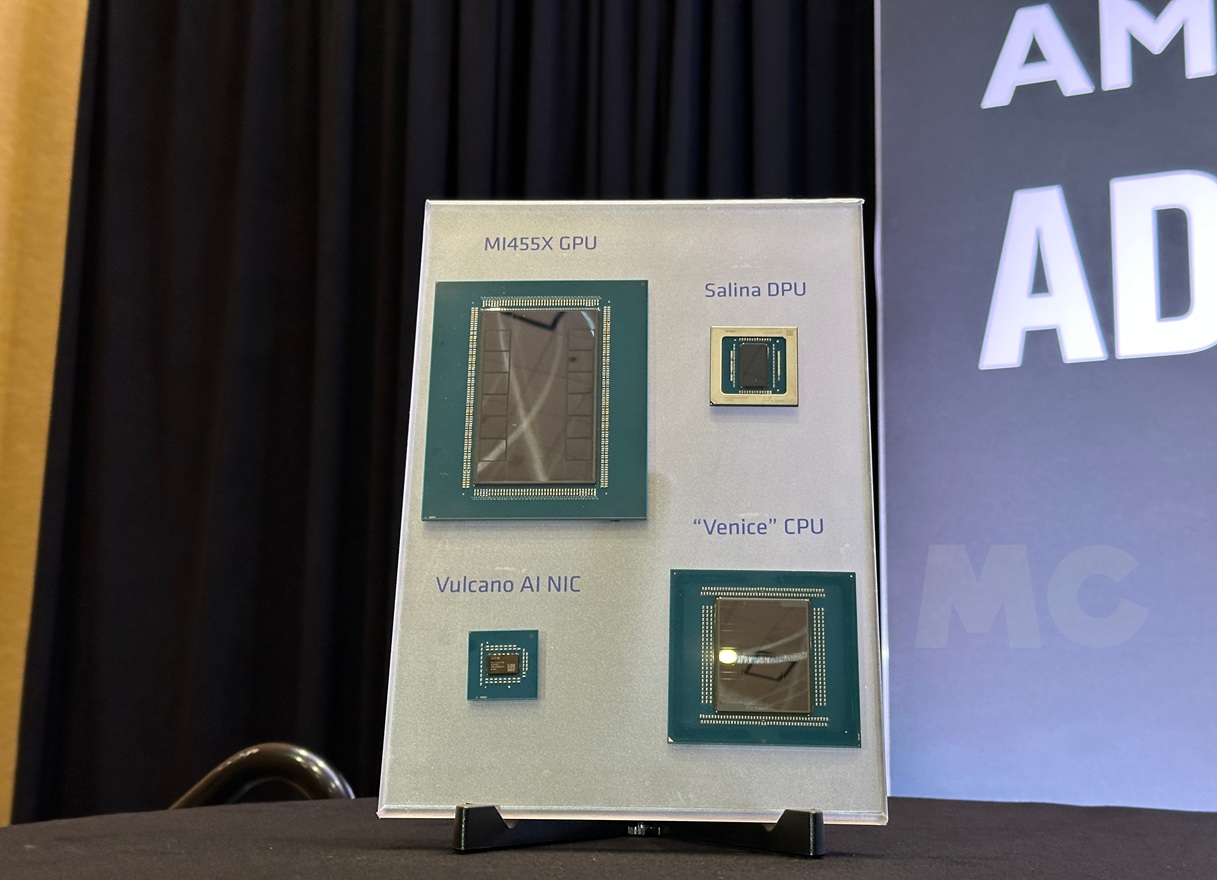
Hace un par de meses tuvimos la oportunidad de asistir al evento Advancing AI 2026 que AMD celebró en San Francisco, un escenario de gala que la compañía de Sunnyvale aprovechó para presentar EPYC Venice, su nueva generación de procesadores basados en la arquitectura Zen 6, y también vimos otros anuncios importantes, como las aceleradoras Instinct MI455X y su primer sistema de IA a escala de rack, AMD Helios, que fue sin duda uno de los grandes protagonistas del evento.
En este evento también pudimos confirmar que la IA está viviendo una importante fase de transformación, con cambios que se están dejando notar tanto a nivel de hardware como de software, una realidad que, como es lógico, está transformando las necesidades de las empresas a nivel de infraestructura, y planteando nuevos desafíos a los que AMD ha dado respuesta con todo lo presentado en el Advancing AI 2026.
Hemos tenido la oportunidad de hablar de todos estos temas con AMD en una entrevista muy interesante, y le hemos dado un enfoque amplio os ayudará a resolver muchas dudas, tanto si vuestra empresa ya se subió al tren de esa primera ola de IA y ya estáis preparando la adopción de la IA agéntica como si aún no habéis dado el paso, pero lo estáis considerando y queréis valorar diferentes opciones.
[MCPRO] Actualmente estamos presenciando una gran transición en el mundo de la IA, pasando del modelo de chatbot tradicional a la IA agéntica. Esto está reconfigurando por completo el panorama tanto a nivel de hardware como de software. Para los lectores que aún no tengan claras las diferencias entre ambos, ¿podría explicar qué los distingue y qué supone este cambio para la infraestructura?
[Cyril Laurie] La distinción más sencilla es que la IA conversacional tradicional principalmente responde, mientras que la IA agéntica cada vez actúa más. Un agente puede planificar una secuencia de pasos, llamar a herramientas y aplicaciones, trabajar con datos empresariales, ejecutar tareas y coordinar otras partes de un flujo de trabajo en lugar de limitarse a generar una respuesta a una instrucción.
Eso cambia la ecuación de la infraestructura. El modelo en sí es solo una parte de la carga de trabajo. También hay agentes ejecutándose de forma concurrente, datos que se están recuperando, aplicaciones y API que se están llamando, memoria y estado del sistema que se están gestionando, y aceleradoras a las que hay que suministrar datos de manera continua.
Por ello, cada vez contemplamos más la IA como un problema de sistemas. Las GPU siguen siendo fundamentales para el cálculo de IA altamente paralelo, pero las CPU, la memoria, las redes y el software desempeñan papeles importantes y complementarios. El objetivo es optimizar el flujo de trabajo completo en lugar de maximizar el rendimiento de un solo componente de forma aislada. Ese equilibrio a nivel de sistema se vuelve aún más importante a medida que las cargas de trabajo agénticas se vuelven más complejas y persistentes.
[MCPRO] Durante el evento Advancing AI 2026, AMD demostró que está preparada para liderar la era de la IA agéntica. Los nuevos procesadores AMD EPYC Venice fueron sin duda uno de los principales atractivos, no solo por sus mejoras de rendimiento y su mayor densidad de núcleos, sino también por su nueva segmentación en cinco categorías diseñadas para diferentes cargas de trabajo y tipos de organizaciones. ¿Qué hace que estos procesadores sean una opción tan sólida para la computación en la nube, la HPC y la IA?
[Cyril Laurie] Lo importante de la 6.ª generación de AMD EPYC no es simplemente tener más núcleos, sino ofrecer a los clientes diferentes enfoques de diseño para tareas muy distintas en el centro de datos.
La IA agéntica lo ilustra con mucha claridad. Algunas CPU necesitan una densidad muy alta de núcleos e hilos para ejecutar muchos agentes simultáneamente. Los nodos anfitriones de IA necesitan frecuencia, ancho de banda y capacidad de E/S para mantener la productividad de los aceleradores. Las cargas de trabajo técnicas y de HPC pueden beneficiarse de un ancho de banda elevado de memoria y caché, mientras que los entornos empresariales y de nube pueden priorizar la eficiencia y las configuracionesespecíficas.
La gama EPYC 9006 está diseñada en torno a esos diferentes requisitos. En la gama más alta, escala hasta 256 núcleos y 512 hilos por zócalo, con soporte para PCIe Gen 6 y memoria avanzada. El EPYC 9006X se dirige a cargas de trabajo técnicas y de HPC sensibles a la memoria, mientras que el EPYC 9006 LP está diseñado específicamente como CPU anfitriona para sistemas acelerados de alta densidad.
La ventaja es la capacidad de elección dentro de una arquitectura EPYC y un ecosistema de software comunes: los clientes pueden adaptar la CPU a la carga de trabajo en lugar de estirar un único diseño para cada tarea.
[MCPRO] Las GPU siguen siendo importantes en la era de la IA agéntica, pero las CPU han asumido un papel mucho más destacado y se han convertido en una parte central de esta nueva etapa. Este es un tema especialmente interesante que puede que muchos de nuestros lectores aún no entiendan del todo. ¿Podría explicar por qué la CPU se ha vuelto tan importante y qué papel desempeña en la IA agéntica?
[Cyril Laurie] Un error habitual es pensar que un sistema de IA es simplemente una GPU ejecutando un modelo. La GPU es enormemente importante, pero también hay mucho trabajo alrededor del modelo, que debe realizarse de forma eficiente.
En un entorno agéntico, las CPU ejecutan y coordinan agentes, realizan tareas y código fuera del acelerador, gestionan la memoria y el estado del sistema, gestionan la E/S, conectan agentes a aplicaciones y datos empresariales, y actúan como procesadores anfitriones que mantienen a las GPU abastecidas de trabajo, garantizando que estas tengan un flujo constante de tareas/datos
Esto se vuelve más significativo a medida que se aumenta el número de agentes. Ya no se procesa una sola instrucción y una sola respuesta; potencialmente hay muchos flujos de trabajo ejecutándose simultáneamente e interactuando con bases de datos, aplicaciones, sistemas de recuperación y otros servicios.
Por este motivo, AMD describe una arquitectura emergente creada alrededor de la ejecución de agentes, los nodos anfitriones de IA y el cómputo empresarial de propósito general. La CPU y la GPU no compiten por el mismo trabajo. Realizan tareas diferentes, y conseguir el equilibrio adecuado entre ellas ayuda a mejorar la utilización y la eficiencia general del sistema.
[MCPRO] Pasando a las GPU, las aceleradoras AMD Instinct MI455X están diseñadas para ofrecer no solo un alto nivel de rendimiento, sino también una notable versatilidad gracias a su configuración HBM4 y al soporte nativo para FP4 y formatos de mayor precisión. Esto permite utilizar la cuantización de 4 bits y optimizar incluso los modelos más grandes de forma más eficaz. ¿Qué mejoras clave podemos esperar en comparación con la AMD Instinct MI355X?
[Cyril Laurie] La MI455X representa un salto generacional sustancial orientado específicamente a la IA de vanguardia (frontier AI), el entrenamiento, el ajuste fino (fine-tuning) y la inferencia de gran volumen.
La memoria es uno de los cambios más evidentes. La MI455X ofrece 432 GB de HBM4 por GPU en comparación con los 288 GB de HBM3E de la MI355X (un 50 % más de capacidad), mientras que el ancho de banda de memoria pico pasa de 8 TB/s a 23,3 TB/s. Esa capacidad y ancho de banda adicionales adquieren cada vez más valor a medida que crecen los modelos y las ventanas de contexto, y a medida que más datos deben permanecer cerca del cómputo.
También hay un incremento importante en el cómputo de IA pico. La MI455X ofrece 40,3 PFLOPS de rendimiento pico en OCP MXFP4, aproximadamente cuatro veces la cifra de la MI355X, y 20,1 PFLOPS en OCP MXFP8 frente a los 5 PFLOPS de la MI355X. El rendimiento matricial pico en FP16/BF16 se duplica, pasando de 2,5 a 5 PFLOPS.
Pero la arquitectura del sistema es igual de importante: la MI455X se diseñó específicamente para escalar a través de AMD Helios, en lugar de ser simplemente una GPU independiente más rápida.
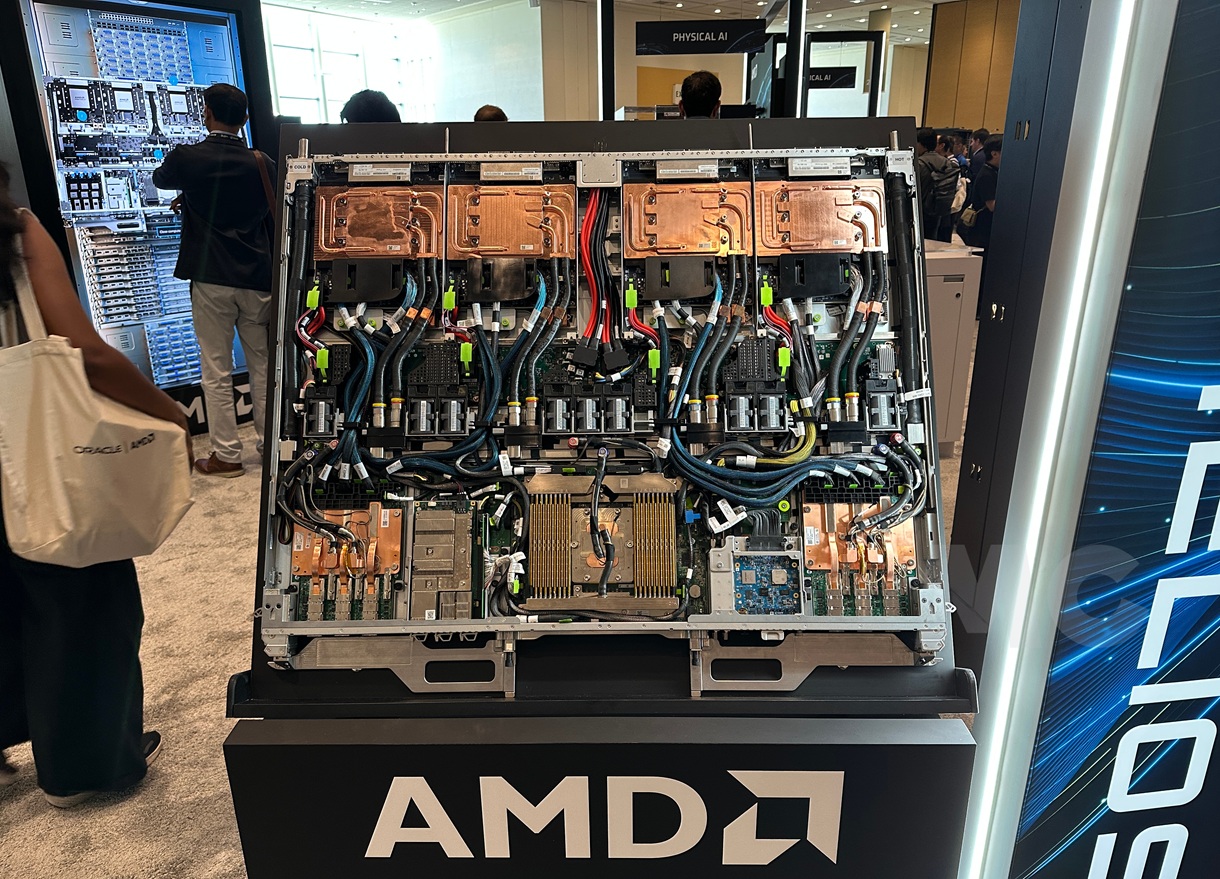
[MCPRO] Para las grandes empresas que buscan una solución de IA completa a escala de rack, AMD Helios ha emergido como una plataforma innovadora y de gran capacidad. Combina una gama equilibrada de componentes que cubren cada capa —desde la CPU y la GPU hasta la DPU y la NIC— con un alto grado de integración. ¿Cuáles son las principales ventajas de este tipo de solución?
[Cyril Laurie] La principal ventaja es poder optimizar la infraestructura de IA como un sistema completo y no componente por componente.
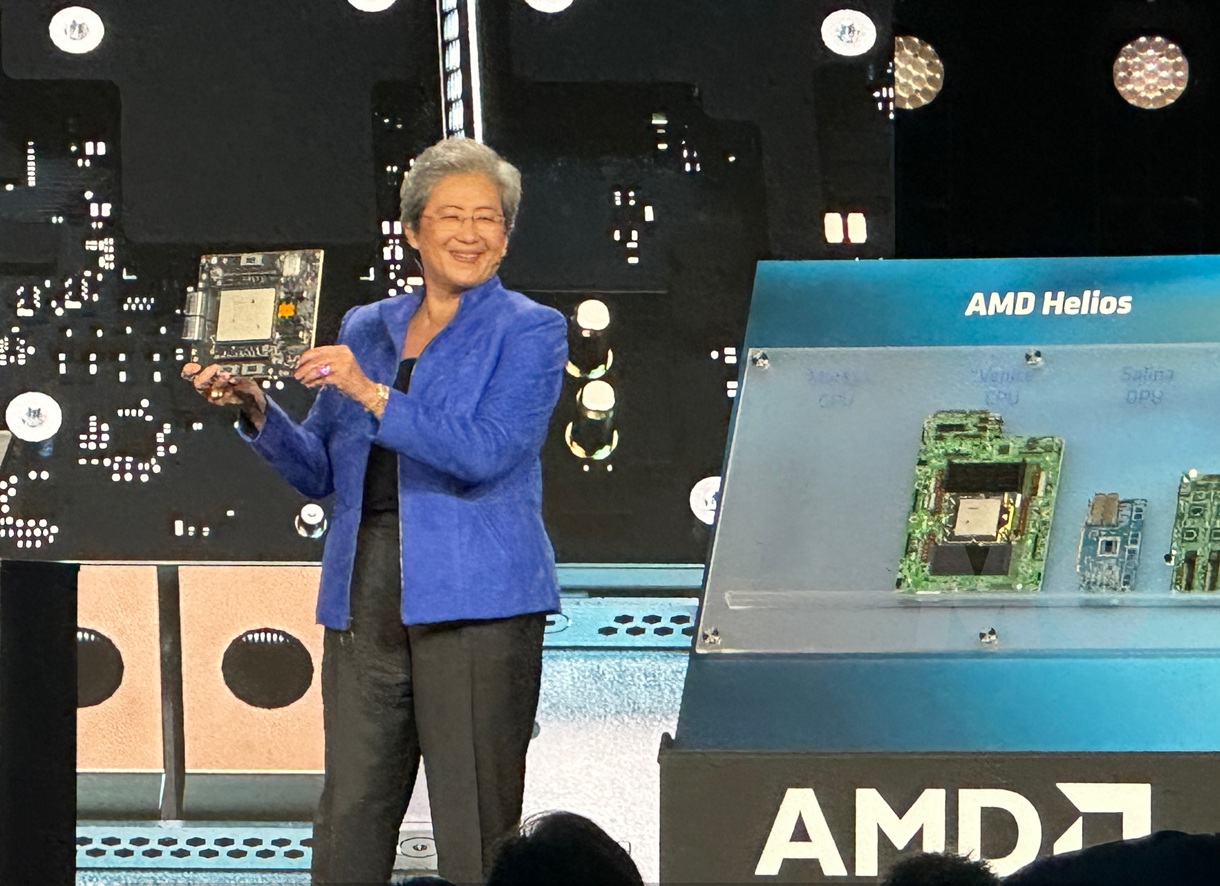
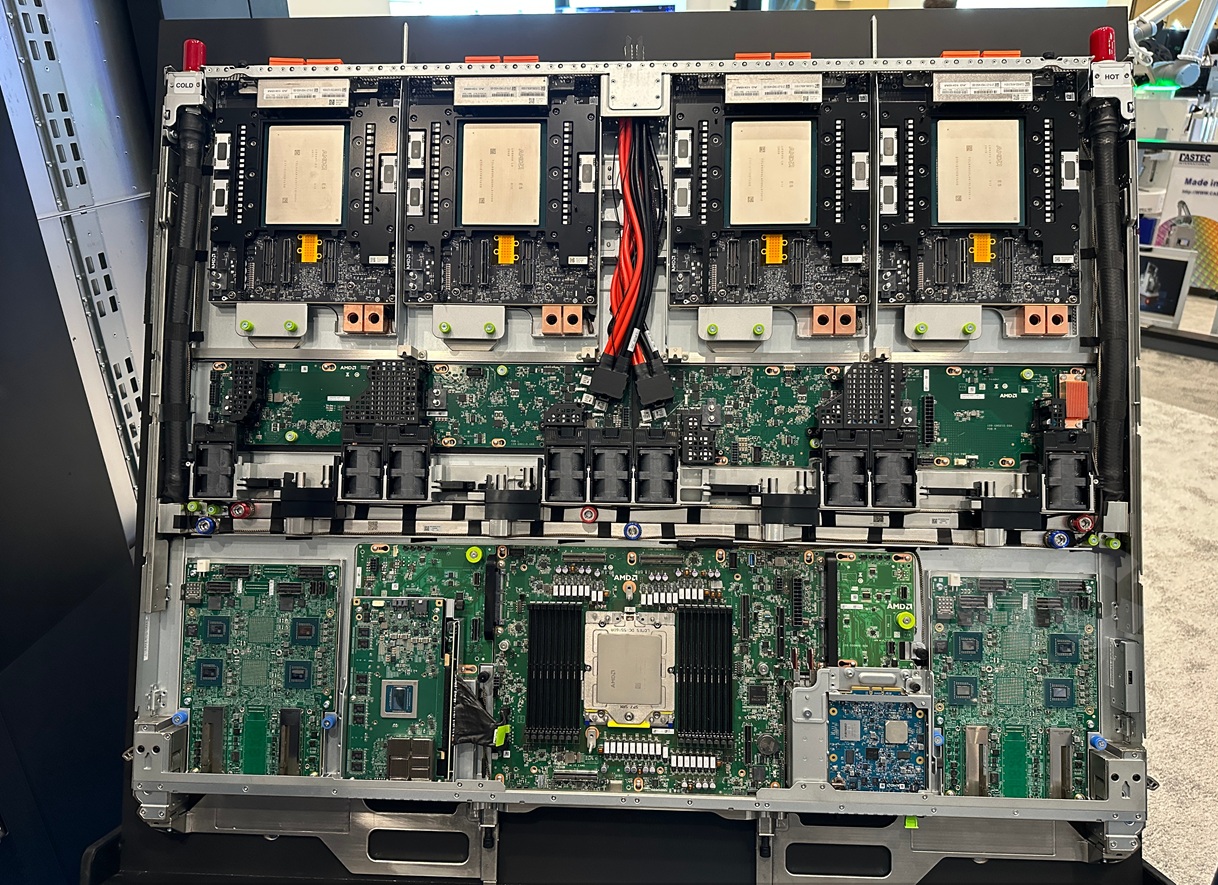
Helios reúne 72 GPU AMD Instinct MI455X, CPU AMD EPYC de 6.ª generación, redes AMD Pensando y el software ROCm en una arquitectura a escala de rackcodiseñada. Por tanto, el cómputo, la memoria, las redes de escalado vertical (scale-up), las redes de escalado horizontal (scale-out), la alimentación, la refrigeración y el software comparten un diseño de sistema común en lugar de integrarse únicamente tras seleccionar los componentes.
Esto resulta clave tanto a nivel operativo como técnico. Un rack Helios proporciona hasta 31 TB de HBM4 y está construido para escalar desde un solo rack hasta clústeres mucho mayores. Dentro del rack, UALink sobre Ethernet crea un dominio de escalado vertical de alto ancho de banda; entre racks, la conectividad Ethernet basada en estándares proporciona la base para el escalado horizontal.
El otro aspecto fundamental es la apertura. Helios se alinea con tecnologías como OCP Open Rack Wide y estándares abiertos de redes, ofreciendo a los clientes un sistema altamente integrado sin convertir la infraestructura propietaria en la única vía para escalar.
[MCPRO] Volviendo a AMD Helios, su alto grado de integración y la estrecha coordinación entre componentes, refrigeración y cableado pueden suscitar dudas sobre qué ocurre cuando falla un componente o se produce un error. ¿Cómo responde AMD Helios ante estas situaciones y qué mecanismos de protección o redundancia incluye para garantizar la continuidad del servicio?
[Cyril Laurie] La fiabilidad y la capacidad de mantenimiento se han considerado factores de diseño desde el principio, ya que a esta escala se debe asumir que determinados enlaces o componentes requerirán mantenimiento ocasional sin interrumpir todo el sistema.
Un ejemplo es la red de escalado vertical (scale-up). En Helios, cada GPU se conecta mediante múltiples rutas independientes de UALink sobre Ethernet distribuidas por todo el rack. Si un fallo de hardware afecta a una ruta, el tráfico puede continuar a través de rutas alternativas, lo que ayuda a preservar el dominio de la GPU y permite que las cargas de trabajo sigan ejecutándose. AMD Fabric Manager y AMD Fabric OS aportan las capacidades de gestión, telemetría y resolución de fallos en ese entramado (fabric).
También hemos diseñado Helios pensando en la facilidad de mantenimiento a nivel de rack. La arquitectura Open Rack Wide proporciona más espacio físico para el acceso y las reparaciones, mientras que prestaciones como la refrigeración líquida de desconexión rápida buscan hacer más práctico el mantenimiento de una infraestructura de IA de alta densidad. Además, Helios admite pods virtuales o vPods, que permiten aislar partes de la red de GPU para contener los fallos sin afectar necesariamente a todo el rack.
El principio general es que la resiliencia debe diseñarse dentro del sistema (a través de la red, el software y la arquitectura física del rack) en lugar de añadirse tras el despliegue.
[MCPRO] AMD sigue apostando por los estándares abiertos, y la última versión de ROCm es un claro ejemplo de este enfoque. El software es compatible con PyTorch, TensorFlow y JAX, lo que significa que los desarrolladores no necesitan reescribir su código al alejarse del ecosistema CUDA de NVIDIA. Esto facilita y economiza grandes cambios en la infraestructura. Con ROCm.AI, AMD ha dado otro paso en la dirección correcta al simplificar considerablemente las tareas de desarrollo. ¿Cuáles son las principales ventajas de utilizar ROCm.AI y qué planes tiene AMD para reforzar aún más su posición frente a NVIDIA CUDA?
[Cyril Laurie] Nuestro objetivo no es sustituir un ecosistema cerrado por otro, sino hacer que las plataformas de AMD sean más fáciles de adoptar, permitiendo al mismo tiempo que los desarrolladores trabajen con los entornos (frameworks) y herramientas que ya utilizan.
ROCm.ai da un paso importante en esa dirección. Combina la CLI de ROCm para instalar, validar, servir y gestionar cargas de trabajo de IA con AMD Skills, que aporta la experiencia desarrollada por AMD a asistentes de código como Claude, Cursor y Codex. También incluye optimización de software impulsada por IA y Hyperloom, un sistema agéntico de código abierto diseñado para automatizar partes de la optimización de la inferencia.
El resultado es un menor tiempo invertido en ensamblar entornos manualmente, consultar documentación y ajustar el software, y más tiempo dedicado a llevar las cargas de trabajo a producción.
Además, seguimos ampliando la compatibilidad con entornos y modelos, mejorando el rendimiento en el hardware existente a través del software. La portabilidad forma parte de esa estrategia, lo que incluye herramientas como HIP y HIPIFY que ayudan a los desarrolladores a migrar código CUDA. El objetivo se centra en la productividad del desarrollador, el rendimiento y la capacidad de elección, no en forzar a los desarrolladores a adoptar otro modelo de programación propietario.
[MCPRO] Un hardware y un software sólidos son esenciales, pero las alianzas también desempeñan un papel fundamental en esta industria. Entre los ejemplos recientes destacan las colaboraciones de AMD con Microsoft y Anthropic, que cuentan con Helios como pilar central. ¿Qué otras alianzas prevé establecer o ampliar AMD a lo largo de este año?
[Cyril Laurie] Las alianzas son fundamentales porque ninguna empresa entrega infraestructura de IA a escala de forma aislada. Implica el trabajo conjunto de desarrolladores de modelos, proveedores de nube, empresas de sistemas, especialistas en redes, ecosistemas de software y clientes.
En lugar de comentar alianzas que aún no se han anunciado, me fijaría en la trayectoria proyectada. AMD continúa ampliando la colaboración en todo el ecosistema de IA: desde organizaciones que construyen y operan infraestructuras de IA a gran escala, hasta plataformas empresariales y de la nube, proveedores de sistemas y redes, desarrolladores de software y creadores de modelos.
El objetivo no es simplemente añadir más socios, sino hacer que una plataforma de IA abierta de AMD sea más fácil de desplegar en los entornos que los clientes ya utilizan, ofreciéndoles a la vez una mayor libertad de elección en cuanto a cómputo, redes, software y arquitectura de sistemas.
A medida que la infraestructura de IA se vuelve más compleja y avanza hacia despliegues a escala de rack y de clúster, este enfoque de ecosistema cobra aún más importancia. Las plataformas más sólidas serán aquellas que combinen la innovación a nivel de componentes con una amplia interoperabilidad y la capacidad de integrarse en diferentes tecnologías y modelos en despliegue.
[MCPRO] Al evaluar el valor de una infraestructura de IA, a menudo nos referimos a métricas como tokens por segundo y agentes por vatio. ¿Podría explicar qué significan estos conceptos, por qué son importantes y cómo ayudan a las organizaciones a evaluar el valor de una solución de IA?
[Cyril Laurie] Los tokens por segundo son fundamentalmente una medida del rendimiento de la inferencia (throughput): la rapidez con la que el sistema puede generar la salida del modelo. Resulta útil porque, según la carga de trabajo y el objetivo de latencia, un mayor rendimiento puede significar atender más solicitudes o completar más trabajo de IA con la misma infraestructura.
La IA agéntica introduce otra dimensión. Si se ejecuta un gran número de agentes de forma concurrente, también es necesario comprender la eficiencia con la que la infraestructura soporta esa concurrencia. De ahí surgen métricas como los agentes por vatio, agentes por dólar o agentes por rack: cuánta capacidad útil de agentes se puede soportar dentro de las limitaciones de energía, coste o espacio.
Sin embargo, estas métricas requieren contexto. La metodología actual de conteo de agentes de AMD utiliza los recursos de hilos de CPU disponibles como un indicador bajo una carga de trabajo teórica constante, y AMD señala explícitamente que la capacidad real de agentes varía en función de la carga de trabajo, el modelo, la memoria, el software, la orquestación y la configuración del sistema.
Por tanto, ninguna métrica por sí sola cuenta la historia completa. En última instancia, los clientes deben evaluar conjuntamente el rendimiento útil, la capacidad de respuesta, la eficiencia energética, la utilización y el coste.
[MCPRO] Los anuncios de AMD en el evento Advancing AI 2026 también destacaron dos tendencias importantes. La primera es el creciente nivel de especialización en cada capa de hardware. Esto ya no se limita a ofrecer diferentes tipos de CPU, sino que ahora se extiende a las unidades de procesamiento de datos y soluciones de red. La segunda es la creciente importancia de la integración y el software. ¿Cree que estas dos tendencias continuarán a largo plazo?
[Cyril Laurie] Sí, porque de hecho ambas tendencias se refuerzan mutuamente.
Las tareas de IA son cada vez más diversas. Ejecutar muchos agentes simultáneamente es diferente de entrenar un modelo de vanguardia; la inferencia es distinta de la simulación científica; las redes del centro de datos en el front-end tienen requisitos diferentes a los del escalado vertical (scale-up) y horizontal (scale-out) de aceleradoras. Esto impulsa de forma natural una mayor especialización en las CPU, GPU, DPU, NIC y otras partes del sistema.
Sin embargo, a medida que se añaden componentes especializados, la integración se vuelve más importante, no menos. El valor proviene de la eficacia con la que esos componentes operan juntos: cómo se mueven los datos, cómo se utiliza la memoria, cómo se mantienen ocupadas las aceleradoras, cómo escala la red y cómo acceden los desarrolladores a todo a través de la capa de software.
Helios es un buen ejemplo de esa dirección: la CPU, la GPU, la red, la arquitectura de rack y el software ROCm están diseñados como partes de una misma plataforma.
Por lo tanto, espero que ambas tendencias continúen: cómputo y redes más especializados, pero ofrecidos de manera creciente mediante sistemas integrados basados en estándares y en un entorno de software abierto.
[MCPRO] Algunas empresas creen que han perdido la oportunidad de la IA, que están entrando demasiado tarde en el mercado y que ya no merece la pena invertir porque no podrán diferenciarse sin realizar una inversión descomunal. ¿Qué le diría a los directores de tecnología (CTO) de esas empresas?
[Cyril Laurie] Les diría que no confundan ser los primeros con crear valor.
La mayoría de las empresas no necesitan crear el modelo fundacional más grande del mundo para beneficiarse de la IA. El punto de partida más útil es identificar dónde puede la IA mejorar un proceso de negocio, un producto o una experiencia de cliente específicos, y diseñar después la infraestructura en función de ese requisito.
Eso significa también que no es necesario tomar una decisión de infraestructura enorme e irreversible. Diferentes cargas de trabajo requerirán distintas combinaciones de CPU, GPU, redes y modelos de despliegue, y esos requisitos seguirán cambiando. Un entorno de software abierto y una estrategia de infraestructura heterogénea brindan a las organizaciones más margen para empezar donde el valor sea más claro y evolucionar a partir de ahí.
Esto resulta aún más relevante con la IA agéntica, porque los agentes conectan los modelos con las aplicaciones, los datos y los procesos con los que las empresas ya operan. Por lo tanto, la diferenciación no procede únicamente del modelo en sí, sino de la eficacia con la que una organización aplica la IA a su propia información, conocimiento y flujos de trabajo.
Lo importante es construir pensando en la adaptabilidad, en lugar de intentar predecir una única arquitectura de IA permanente.
[MCPRO] Como nota final, no dude en concluir con cualquier reflexión o conclusión adicional que desee compartir.
[Cyril Laurie] Una conclusión de todo lo que hemos debatido es que la infraestructura de IA se está convirtiendo en una inversión estratégica a largo plazo, en lugar de una mera cuestión de añadir más aceleradoras. A medida que los sistemas escalan, las organizaciones deben pensar en toda la arquitectura (CPU, GPU, memoria, redes, software, alimentación y refrigeración) y en cuánta flexibilidad les deja esa arquitectura a medida que evoluciona la IA.
Esto es especialmente relevante hoy en Europa, donde los gobiernos y la industria analizan cómo construir una capacidad de cálculo de IA significativamente mayor. La nueva convocatoria de la UE para crear hasta siete Gigafactorías de IA es un ejemplo muy concreto de ese paso de la experimentación hacia infraestructuras a gran escala.
Para España, esto genera una oportunidad importante para reflexionar no solo sobre cuánto cómputo se despliega, sino sobre el tipo de ecosistema de IA que esa infraestructura puede sostener a largo plazo. España se encuentra entre los Estados miembros que participan en el marco de contratación conjunta para la iniciativa de las Gigafactorías.
Es precisamente aquí donde las tecnologías abiertas tienen una ventaja práctica. Una mayor capacidad de IA y una mayor soberanía tecnológica son más fáciles de conciliar cuando las organizaciones mantienen la libertad de elección en el cómputo, las redes, el software y los modelos, en lugar de depender de una sola arquitectura cerrada. Ese principio —infraestructura abierta e interoperable que preserve la capacidad de adaptación— es central en el enfoque de AMD para la IA soberana.
Por lo tanto, para España, la oportunidad no consiste simplemente en añadir más capacidad de IA. Consiste en construir una infraestructura que pueda dar soporte a la industria, la investigación y la innovación, manteniéndose lo suficientemente flexible como para evolucionar a medida que cambia la tecnología.
[MCPRO] Muchas gracias por su tiempo.






«La infraestructura de IA es una inversión estratégica a largo plazo»

HP Wolf Security revela falsos agentes de IA para robar criptomonedas

ASUS lanza el Ascent QN10 para IA local

Europa restringirá el acceso de menores de 13 años a redes sociales

Snowflake anuncia la disponibilidad de AI Data Cloud en la región AWS Europa (España)

AMD subirá un 10% el precio de sus chips desde el último trimestre de 2026

Casi la mitad del uso de IA empresarial elude la seguridad corporativa y crea lagunas de visibilidad

Globant nombra COO a Fernando Matzkin

Tim Cook se despide de la comunidad y da la bienvenida al nuevo CEO de Apple

Expertos internacionales estudian los riesgos catastróficos de la IA

Intel detalla su nueva plataforma de procesamiento Xeon 7 ‘Diamond Rapids’

Los centros de datos en España tendrán que consumir un mínimo del 80% de energía renovable
«La infraestructura de IA es una inversión estratégica a largo plazo»

NVIDIA sube los precios de sus chips para servidores de IA

SanDisk introduce nuevos SSD para NAS

Los ingresos por ventas de semiconductores en 2026 llegarán a 1,6 billones
Expertos internacionales estudian los riesgos catastróficos de la IA
Casi la mitad del uso de IA empresarial elude la seguridad corporativa y crea lagunas de visibilidad
-
 A FondoHace 7 días
El miedo a la IA: más voces piden echar el freno (China incluida), mientras Trump quiere acelerar
-
 ContentHace 7 días
UVic-UCC y Huawei: Cómo crear una base digital más inteligente para el futuro de la educación superior
-
 NoticiasHace 6 días
NVIDIA añade la RTX PRO 5500 Blackwell a su oferta de visualización profesional
-
 NoticiasHace 6 días
Microsoft nombra a Natalia Maeso responsable de Estrategia de Regiones Cloud y Centros de Datos del Sur de Europa