A Fondo
CUDA y el precio de cambiar

«Tres días» frente a «de 6 a 12 meses». La comparación procede del vídeo que Anthropic proyectó en su roadshow, la gira de presentaciones a inversores previa a su salida a bolsa, y se refiere a algo concreto: el tiempo que, según la compañía, tardó su modelo Mythos en poner en marcha el procesamiento de prompt de uno de sus modelos en una GPU AMD MI355X a un nivel de rendimiento útil. Es decir, sin depender del hardware de NVIDIA.
Los 6 a 12 meses son lo que esa misma tarea costaba con enfoques tradicionales, según la experiencia histórica de Anthropic. La cifra ha circulado como señal de que el software que ata la IA a los chips de NVIDIA podría empezar a ceder su férreo monopolio. La pregunta de fondo es cuánto cuesta cambiar de plataforma y quién gana poder de negociación cuando ese coste baja. Ese software es CUDA, la plataforma de NVIDIA de herramientas, bibliotecas y compiladores para programar sus GPU, según la documentación de la propia compañía. Solo funciona en chips de NVIDIA y casi veinte años de ecosistema acumulado hacen costoso salir de ella: cambiar de chip obliga a traducir, recompilar o reescribir parte del software que ejecuta los modelos, un trabajo que hasta ahora se medía en meses de ingeniería.
El vídeo de la presentación del mencionado roadshow incluye una sección titulada «Approach to compute» con Tom Brown, cofundador de la compañía. No hay transcripción oficial, y la de referencia es la que hizo Simon Willison con MacWhisper. Según ella, Brown dijo que Anthropic entrena y sirve Claude «en las cuatro familias principales de chips» (AWS Trainium, Google TPU, GPU de NVIDIA y GPU de AMD), que incorporar una plataforma nueva «llevaba a docenas de ingenieros meses de trabajo» y que «esta vez hicimos que Mythos lo intentara». Mythos, o Claude Mythos Preview, es un modelo de acceso restringido que Anthropic no planea poner a disposición general, aunque lo facilita a los socios de su iniciativa Project Glasswing y a unas 40 organizaciones más. Y esta es la afirmación clave que mencionábamos: Brown afirmó que Claude funcionó en AMD «en solo tres días, con básicamente nada de intervención humana» y que portó o escribió casi el 100% de los kernels, los pequeños programas que ejecutan una operación concreta en la GPU.
La Inteligencia Artificial contribuyendo a liberar de las cadenas del hardware de NVIDIA a ella misma. El alcance de la cifra lo fija la nota al pie del gráfico «Time to onboard new silicon», reproducido por The Decoder. El procesamiento de prompt es la fase de inferencia (el uso de un modelo ya entrenado) en la que el modelo lee la petición, y la nota precisa que el plazo es aproximado y que el nivel de rendimiento útil lo define la propia compañía. No mide entrenamiento, migración completa, equivalencia de rendimiento ni coste monetario, y es material para inversores sin medición independiente. En los extractos publicados, Brown tampoco habla de CUDA ni de su «foso». El documento oficial por escrito es el folleto de la salida a bolsa, el formulario S-1/A presentado ante la SEC, el regulador bursátil de EE. UU. Presenta la computación en varios tipos de chips como un conjunto fungible, es decir, intercambiable según la carga.
CUDA por capas
Una vez lanzado el titular, conviene separar el ecosistema de CUDA en capas, porque el coste de salir de cada una es distinto. En la capa del framework, PyTorch, la biblioteca con la que se construye buena parte de los modelos, ya corre de forma nativa en otros chips. El 20 de octubre de 2026 AWS lanzó en beta pública TorchNeuron para Trainium, su chip propio de IA, y Google publicó como código abierto TorchTPU, codesarrollado con el equipo de PyTorch en Meta, para sus TPU (Tensor Processing Units, los aceleradores diseñados por Google). En la capa de conversión de código, AMD ofrece HIP, un lenguaje y una API de ejecución parecidos a CUDA dentro de su plataforma ROCm, y la herramienta HIPIFY, que traduce código CUDA a HIP. La documentación de AMD sobre HIPIFY detalla los requisitos y los límites de esa traducción.
La tercera capa es la de compiladores y kernels, donde encaja lo que describe Anthropic. Allí conviven Triton, Modular MAX, publicado en octubre con licencia propia y código disponible, y otras herramientas. No todos los kernels exigen una reescritura completa para cada chip, porque pueden traducirse, recompilarse o apoyarse en capas portables, con un trabajo de adaptación y ajuste que varía según el caso. Lo que Anthropic describe abarata, según la compañía, la tarea de poner un modelo a funcionar en otro chip. El rendimiento sostenido, las librerías y la red entre chips son otra cuenta totalmente distinta.
Lo medido, lo declarado y lo que falta
El experimento de Anthropic cubre un modelo, una fase de inferencia y un chip. No mide el entrenamiento distribuido, que exige comunicación entre miles de chips, estabilidad durante semanas y librerías maduras, así que su plazo no puede extrapolarse a esa tarea. La propia Anthropic ya declaró que usa más de un millón de chips Trainium2 para entrenar y servir Claude, una declaración de parte. Tampoco hay una medición independiente del portado con Mythos que tanto nos está intrigando a todos. Podría pasar de amenaza de seguridad a amenaza al monopolio de CUDA.

Las cifras de rendimiento proceden de fabricantes o de pruebas cuyos autores las describen como dependientes de la configuración. El referente abierto es InferenceX de SemiAnalysis, que en su segunda versión ve resultados competitivos en coste por rendimiento para la MI355X en FP8 frente a la B200 con el software SGLang, aunque frente a la B200 con TensorRT-LLM, la opción más extendida de NVIDIA, la ventaja sigue siendo de NVIDIA. El 12 de noviembre AMD comunicó, en su nota sobre la serie Instinct MI400, 21.333 tokens por segundo por GPU con su MI455X sobre DeepSeek-R1 en una configuración MLPerf Inference Offline que probó ella misma, hasta un 30% más que el resultado publicado de NVIDIA Vera Rubin NVL72 en la división cerrada de MLPerf v6.1. MLPerf es el conjunto de pruebas de referencia de MLCommons.
Lo que dice el mapa de contratos
Michael Cembalest, de J.P. Morgan Private Bank, publicó el 14 de noviembre de 2026 el informe «The Icarus Files: What’s next for Nvidia and AI», de la serie Eye on the Market. Un gráfico de su página 4 reparte la capacidad de computación anunciada en acuerdos de los grandes laboratorios de IA con despliegue en 2026 o después, unos 43,9 GW (gigavatios). NVIDIA suma 12,11 GW, el 28%. Le siguen Broadcom, que diseña chips a medida para grandes clientes, con 10 GW (23%), AMD con 8 GW (18%), Amazon Trainium con 7 GW (16%), Google TPU con 6 GW (14%) y Cerebras con 0,75 GW (2%), porcentajes redondeados.
Son gigavatios anunciados en contratos futuros y no ventas actuales, así que el 28% no permite calcular una caída respecto al 80-90% de cuota de ingresos en chips de IA que el mismo informe atribuye a NVIDIA en 2024 y 2025 según Silicon Analysts. El informe recoge también la anécdota de uno de los grandes laboratorios, sin nombrarlo, según la cual incorporar modelos a GPU de AMD pasó de 6 a 12 meses hace un año a 3 días con su último modelo. Curioso que la cifra coincida con lo que dice Anthropic. Cembalest sostiene que NVIDIA aguantará a corto plazo por sus márgenes (83% de los ingresos en chips de IA entre 2023 y 2025, margen bruto del 75% y operativo del 66%) y que el panorama competitivo «puede estar intensificándose». Incluye además una estimación modelada de Epoch AI, del 9 de noviembre, que sitúa a la MI455X por encima de la GB300 en rendimiento de inferencia por chip.
NVIDIA: poder de negociación antes que volumen
El cuadro de la situación sigue protegiendo al NVIDIA, portar una carga de un chip a otro cuesta dinero y tiempo, y ese coste contribuye a sostener su capacidad de negociación. Si este coste baja y se simplifica la operación, el comprador no necesita mover la carga para beneficiarse: le basta con que el proveedor sepa que podría hacerlo. Una amenaza creíble de cambio mejora las condiciones de un contrato, y esa presión se notaría antes en precio y margen que en volumen mientras la demanda supere a la oferta. Ese es el verdadero cambio de paisaje que podría producirse si se derrocara a CUDA.
Los contrapesos son visibles. NVIDIA facturó 96.200 millones de dólares en el segundo trimestre fiscal de 2027 (+106%), con 89.000 millones en centros de datos y un margen bruto del 75,0%, y prevé 108.000 millones (±2%) para el tercero, según su comunicado de resultados. Anthropic, además, sigue comprándole. NVIDIA es proveedor, socio técnico desde la alianza de noviembre de 2025, con una inversión de hasta 10.000 millones de dólares, e inversor en la colocación privada de 26.000 millones de dólares que recoge el S-1/A, ligada a la salida a bolsa. Para Anthropic, la portabilidad es a la vez argumento de venta ante inversores y herramienta de negociación con todos sus proveedores.
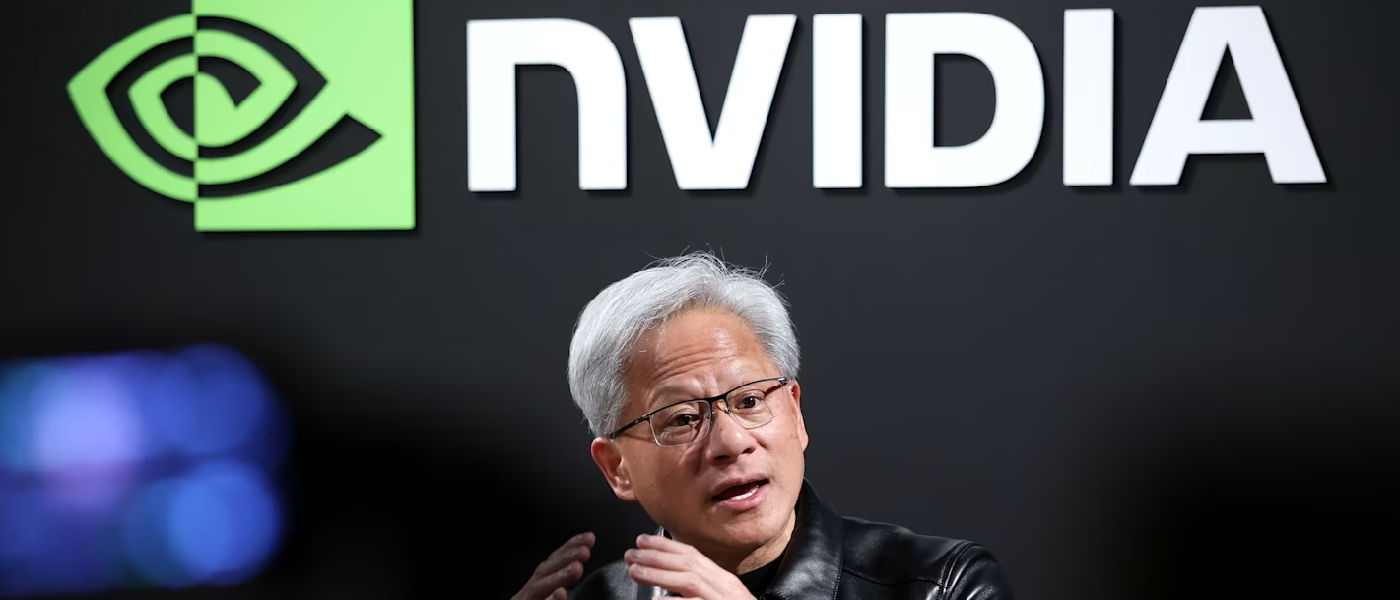
Pero las piezas sobre el tablero han cambiado y esto es un detalle importantísimo. La compañía anunció el 12 de noviembre la dimisión de Jensen Huang como CEO, presidente y consejero, y su documento ante la SEC fecha la aceptación el 11 de noviembre y no indica el motivo. Colette Kress, directora financiera, es CEO interina y Harvey C. Jones preside el consejo. En MuyComputerPRO analizamos esa salida. Según Cembalest, la acción cotiza un 32% por debajo de su máximo histórico tras caer un 13%, y HSBC rebajó el 13 de noviembre la recomendación a «hold», con un precio objetivo de 170 dólares, y dijo que la incertidumbre persistirá hasta que haya un CEO permanente. Esto junto a la pérdida de puntos de apoyo de la palanca de CUDA puede ser dramático para NVIDIA.
Cabe distinguir cuatro escenarios. En el primero, los grandes compradores reparten sus cargas entre varios chips y NVIDIA pierde capacidad de negociación frente a ellos. En el segundo, el portado asistido por IA llega a la empresa media. En el tercero se erosiona también el entrenamiento, el que menos evidencia reúne porque la red entre chips y el sistema completo siguen siendo ventaja de NVIDIA. El cuarto es el efecto del momento: con dirección interina y resultados a la vista, la narrativa puede pesar más que los hechos a corto plazo, mientras el consejo afirma que operaciones y compromisos con clientes continúan sin interrupción. Para situar a los competidores, MuyComputerPRO analizó el 10 de noviembre quién podría ocupar el sitio de NVIDIA si todo fuera horriblemente mal.
Quién se beneficia y con qué límites
AMD es el beneficiario más directo de este movimiento de independencia, porque ofrece la alternativa de GPU de uso general y es el chip del caso de Anthropic. En el tercer trimestre de 2026 ingresó 13.400 millones de dólares (+45%), con 8.500 millones en centros de datos (+97%) y una previsión de unos 17.000 millones para el cuarto, según su comunicado de resultados. Según AMD, Anthropic, Meta, Microsoft, OpenAI y Oracle Cloud ejecutan cargas en los primeros racks Helios, y Microsoft explica en su blog técnico cómo lleva ese sistema a Azure. En MCPro ya analkizamos Helios. Los límites son concretos. La demostración de Anthropic corresponde a la MI355X y no a la MI450, el margen bruto de AMD (54% GAAP) queda por debajo del 75% de NVIDIA y los grandes clientes que prueban AMD también prueban TPU y Trainium, así que no captará todo lo que ceda NVIDIA.
Los hiperescalares, los grandes proveedores de nube como Google y Amazon, controlan su propio hardware y ahora también la capa PyTorch con TorchTPU y TorchNeuron. Broadcom, que fabrica chips a medida para esos clientes, saldría ganando si más compradores diseñan el suyo. Según la transcripción de la llamada de resultados de Broadcom, la compañía despliega este año 1 GW de TPU Ironwood para Anthropic, espera otros 5 GW de TPU 8i en 2027 y ve con claridad otros 10 GW en 2028. Son cifras de la dirección de Broadcom y no de un contrato publicado. Un chip propio solo compensa con mucho volumen e ingeniería, y para el cliente medio la alternativa práctica es alquilar capacidad en la nube del hiperescalar. Intel carece de un acelerador de entrenamiento comercial de peso y apuesta por una GPU de inferencia, Crescent Island, tras el reinicio de su hoja de ruta que describe Jon Peddie Research.
China y Europa
En China, Huawei ha abierto el código central de CANN, el equivalente de CUDA para sus chips Ascend. Según ChinAI, que traduce un reportaje de QBitAI, un fundador de una startup del sector sitúa el ecosistema entre la «infancia» y la «juventud», sin madurez plena. El 30 de septiembre DeepSeek abrió el código de librerías de cálculo y comunicación para Ascend y destacó el papel de TileLang, un lenguaje de programación para chips de IA de código abierto, y afirmó que desarrolló con Huawei un supernodo de 128 chips Ascend 950, según Reuters. Según Epoch AI (estimación actualizada el 24 de septiembre), el Ascend 950 llega en dos variantes con el mismo chip de cálculo.

La 950PR, orientada a la fase de lectura de la petición, da 2 PFLOPS en FP4, y la 950DT, prevista para el cuarto trimestre, da 1 PFLOP/s en FP8, aproximadamente la mitad de una H100, con un ancho de banda de memoria comparable. Epoch estima además que Huawei producirá este año menos del 4% de la computación de NVIDIA, y señala como límite principal la memoria HBM (memoria de alto ancho de banda apilada junto al chip). Huawei prevé volumen de su sistema de entrenamiento a finales de 2026 o principios de 2027, según TrendForce, que también recoge la afirmación de Huawei de que ha superado a NVIDIA en China.
La demanda de NVIDIA en China no ha desaparecido aunque su previsión la excluya. Una investigación de Reuters del 13 de noviembre identificó más de 23.000 millones de yuanes (unos 3.200 millones de dólares) en proyectos chinos de computación construidos en torno a procesadores restringidos de NVIDIA, una cifra que incluye inversiones previstas, contratos firmados e instalaciones terminadas y que cubre edificios y sistemas de energía además de chips. El éxito de las alternativas chinas cambiaría más el reparto dentro de China y la exportación de herramientas abiertas que los ingresos actuales de NVIDIA, porque su previsión del tercer trimestre no incluye ese mercado.
En Europa, el material revisado no recoge un equivalente de CUDA con adopción comparable. Los grandes proyectos conocidos se levantan sobre NVIDIA y AMD, y EuroHPC ha elegido GPU AMD Instinct MI430X para LUMI-AI, en Finlandia, según su comunicado del 31 de agosto. Axelera AI, de Eindhoven (Países Bajos), presentó el 12 de noviembre Titania, una arquitectura de inferencia para centros de datos, con más de 300 millones de dólares en compromisos confirmados y cifras de eficiencia que son de la propia empresa. En el Reino Unido, fuera de la UE, el Gobierno anunció el 11 de noviembre su inversión en Fractile, fabricante de chips de inferencia, en una ronda de más de 500 millones de libras con valoración superior a 5.000 millones. Entre los ejemplos analizados, los de Europa apuntan a soberanía en inferencia, CPU y pila abierta más que a sustituir a CUDA en entrenamiento, sin descartar otras iniciativas.







CUDA y el precio de cambiar

Nextcloud lanza Office Desktop, su suite ofimática de escritorio basada en Euro-Office

Nokia, Nscale, Skeleton, Telia y Verda se unen para abrir una gigafactoría de IA en el Norte de Europa

66.900 millones de euros en cinco años: así opta España a ser la cuarta potencia europea en centros de datos

Los gigantes de las memorias no logran desactivar la demanda antimonopolio

AuraQuantic aboga por rediseñar los procesos para desplegar la IA en el sector asegurador con control y seguridad

50 años de EMACS, el editor que dio origen al software libre

«Con la IA, lo más complicado suele ser la gestión del cambio en la organización»

ONLYOFFICE renueva su alternativa a Microsoft Office y Google Docs para empresas

Tres de cada cuatro directivos españoles encuestados prevén gastar más en ciberseguridad en 2027, con la IA como prioridad

Esade e IBM proponen un modelo de resiliencia para gestionar la dependencia tecnológica desde el consejo

El revés de los centros de datos en las elecciones de EE.UU.: qué puede cambiar para la industria y para España
CUDA y el precio de cambiar

Dell subirá los precios de sus monitores de gama media y alta

Proofpoint compra Varonis para crear un gigante de la ciberseguridad en la era de la IA

BSC AI Factory lanza un primer programa de aceleración para 100 startups españolas de IA

Orange, Telefónica, Vodafone y Deutsche Telekom se unen para competir con Starlink

Salesforce invertirá 1.000 millones de dólares en España para acelerar la IA agéntica
-
 A FondoHace 6 días
¿Quién podría ocupar el sitio de NVIDIA si todo fuera horriblemente mal?
-
 A FondoHace 6 días
AMD EPYC «Venice» a fondo: Zen 6, hasta 256 núcleos y una nueva generación de servidores
-
 A FondoHace 6 días
AMD MEXT: cómo ampliar la memoria RAM con IA y flash
-
 A FondoHace 6 días
Synology FlashStation FS200T, análisis