Noticias
Microsoft restablece Microsoft 365 tras más de 24 horas de caída global por un fallo en su red

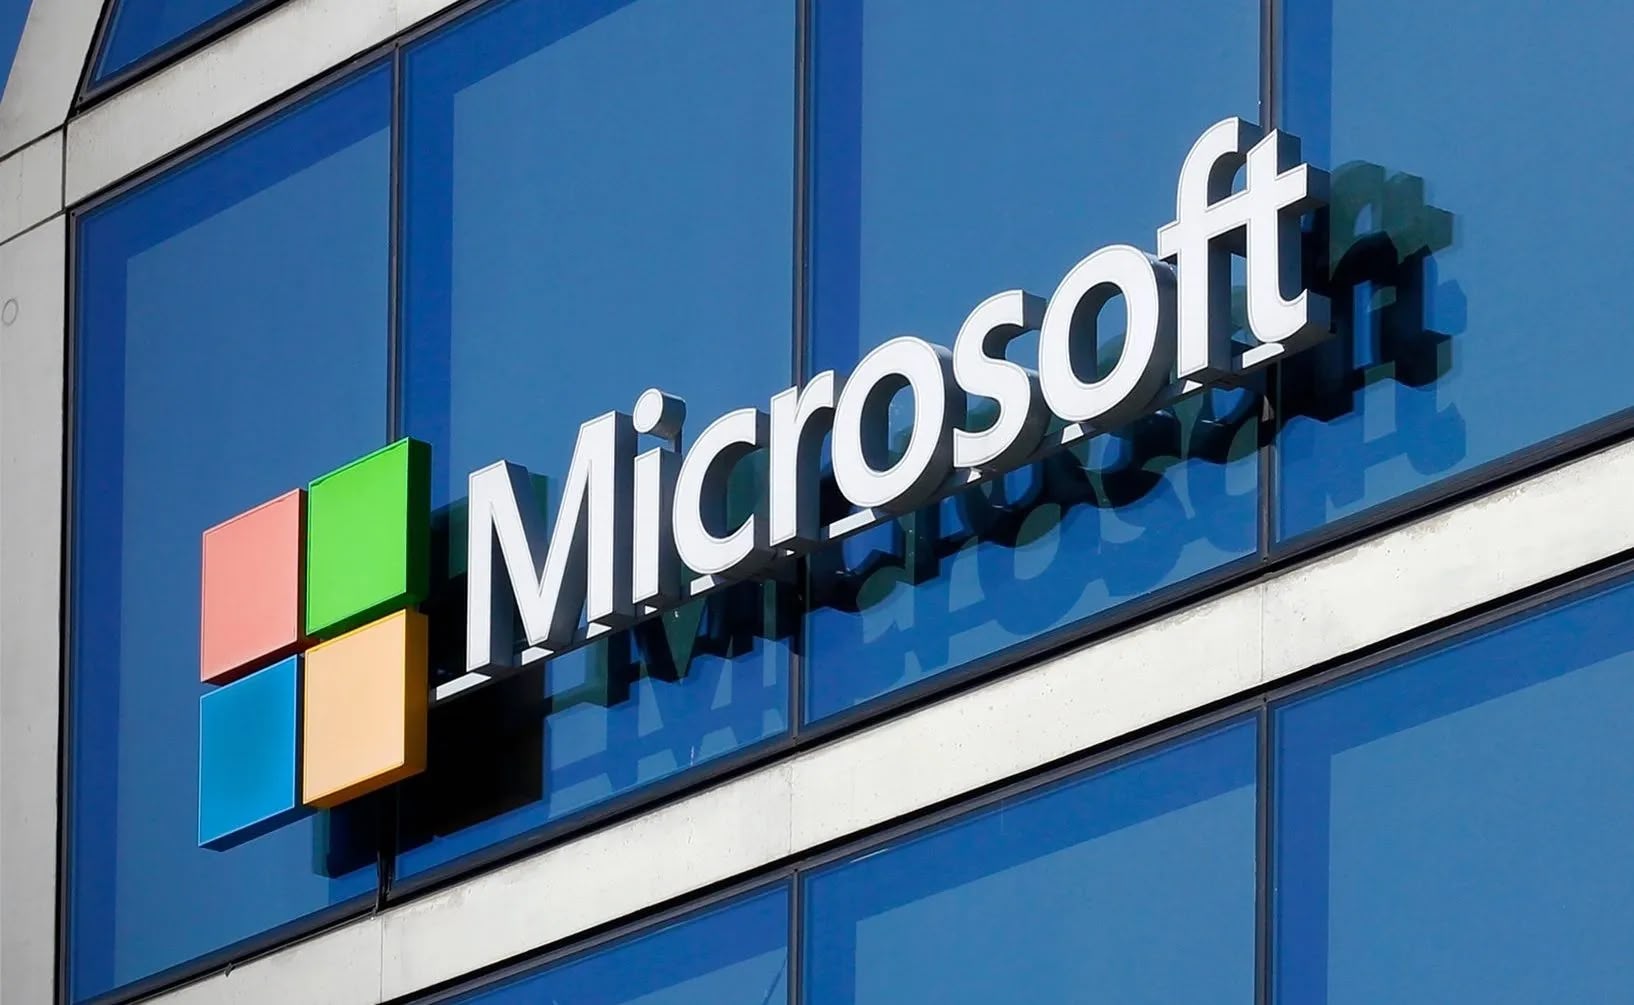
Microsoft ha dado por resuelta la caída global de Microsoft 365 que desde el jueves dejó sin servicio o con graves problemas de acceso a Outlook, Teams, Copilot y el resto de aplicaciones de la suite a empresas y administraciones de más de 70 países. La página oficial de estado del servicio mostraba ya este sábado el mensaje «All products are operational», tanto para Microsoft 365 en su vertiente empresarial como para los productos de consumo, tras una incidencia que ha superado las 24 horas de duración.
El problema comenzó sobre las 12:00 ET (18:00 hora peninsular) del jueves, cuando los usuarios empezaron a reportar fallos de acceso a Outlook que se extendieron en cuestión de horas a buena parte del mundo. La caída llegó a paralizar oficinas gubernamentales y actividad de negocios en varios países, según recogió The Straits Times. El viernes, la compañía confirmó la recuperación completa de sus productos de consumo, mientras los servicios empresariales de Microsoft 365 avanzaban en una recuperación más lenta, tal y como recogimos en nuestra cobertura de la incidencia.
La explicación de Microsoft: un fallo en una actualización de red
Según ha explicado un portavoz de la compañía a Wired, se trató de «un problema técnico no relacionado con ciberseguridad ni con IA o agentes». El incidente, según su versión, se originó durante una actualización de capacidad de red realizada con anterioridad y afloró tras un cambio de red reciente. Microsoft asegura haber resuelto ya el problema subyacente.
The Guardian aporta el detalle técnico: de acuerdo con su información, algunos de los servidores de la compañía quedaron «inesperadamente no disponibles» y fallaron durante las comprobaciones automatizadas posteriores, lo que apunta a que los mecanismos de control no fueron capaces de contener la incidencia en sus primeras fases.
La compañía también ha pedido disculpas de forma pública: «Lamentamos profundamente la alteración que este incidente ha causado a nuestros clientes y socios. Conocemos la confianza que depositan en nuestros servicios y nos tomamos esa responsabilidad muy en serio», señaló en un mensaje publicado en X.
Microsoft atribuye la lentitud de la recuperación a su propia escala: el restablecimiento se hizo de forma gradual, comprobando la estabilidad en cada fase antes de devolver el tráfico completo. Charles Lamanna, vicepresidente ejecutivo de Copilot, Agents and Platform, ha detallado que la investigación identificó fallos en cascada y efectos de «thundering herd» (reconexiones masivas y simultáneas) en el perímetro de la red, que complicaron la recuperación, y ha confirmado que el equipo de ingeniería trabaja en completar el post-mortem del incidente.
Respecto a los efectos residuales, la propia compañía informó el viernes por la mañana (hora ET) de que las colas de correo electrónico acumuladas durante la incidencia se habían reducido significativamente, según recoge AP.
Lo que queda: post-mortem y compensaciones
El post-mortem que la compañía tiene en marcha debería detallar la cadena exacta de fallos y las medidas correctoras. Para las empresas afectadas queda abierto el capítulo de las compensaciones previstas en los acuerdos de nivel de servicio, cuyo marco ya analizamos en la pieza anterior. La incidencia llega, además, en un momento en el que la compañía reconocía públicamente que su capacidad de infraestructura no llega a tiempo para atender una demanda que no deja de crecer.



Microsoft restablece Microsoft 365 tras más de 24 horas de caída global por un fallo en su red

Gemini 4 Hydrogen: Google estrena su modelo rápido y eficiente para el trabajo diario con IA

¿Por qué el phishing se dispara en Europa?

Los ingresos por software de IA superarán los 200.000 millones en 2026

Absentismo laboral, si las cifras hablaran

IBM superará en 2027 la barrera de los 1.000 qubits con el chip cuántico Nighthawk r3

50 años de EMACS, el editor que dio origen al software libre

«Con la IA, lo más complicado suele ser la gestión del cambio en la organización»

ONLYOFFICE renueva su alternativa a Microsoft Office y Google Docs para empresas

Tres de cada cuatro directivos españoles encuestados prevén gastar más en ciberseguridad en 2027, con la IA como prioridad

El revés de los centros de datos en las elecciones de EE.UU.: qué puede cambiar para la industria y para España

Esade e IBM proponen un modelo de resiliencia para gestionar la dependencia tecnológica desde el consejo
Microsoft restablece Microsoft 365 tras más de 24 horas de caída global por un fallo en su red

La IA cambia cómo trabajamos, pero no rebaja la carga laboral

D-Link inicia su 30ª temporada de webinars

Veeam Intelligent ResOps for Microsoft 365: seguridad para usar IA y recuperar datos

Cómo recuperar el valor de las fotografías en la era de la imagen digital

Huawei Connect 2026: IA, multicloud y soberanía
-
 A FondoHace 5 días
NVIDIA investiga el alcance de la relación de su CEO, Jensen Huang, con una supuesta espía china
-
 NoticiasHace 7 días
Los grandes inversores dudan de que la salida a bolsa de Anthropic alcance los 1,5 billones de dólares
-
 A FondoHace 4 días
¿Quién podría ocupar el sitio de NVIDIA si todo fuera horriblemente mal?
-
 NoticiasHace 6 días
El gasto en infraestructura de IA crece un 53 % y ya apunta a 521.000 millones de dólares en 2026