A Fondo
Intel avanza sus próximas soluciones para HPC en la conferencia SC26

Intel ha compartido nuevos detalles de sus próximas soluciones para HPC en la conferencia SC26 que se celebra esta semana en Chicago. Las novedades pasan por sus próximos procesadores Xeon 7 ‘Diamond Rapids’ y las aceleradoras de la serie D, y ofrecen una visión más cercana del hardware de CPU y GPU para servidores de próxima generación de Intel, incluyendo un número de núcleos significativamente mayor, un mayor ancho de banda de memoria y configuraciones de hardware de gran capacidad orientadas a cargas de trabajo de IA y computación de alto rendimiento.
Intel ha mostrado su compromiso con el segmento HPC y con base en una realidad pragmática que ha comentado en la presentación Jeff McVeigh, vicepresidente y director general de Programas Estratégicos para Centros de Datos: «el progreso proviene de combinar las tecnologías adecuadas, no de forzar la computación científica a una única arquitectura o modelo de programación. Creemos que el futuro de los sistemas HPC es abierto, heterogéneo y equilibrado, integrando CPU, aceleradores, software y conectividad para aprovechar décadas de inversión en aplicaciones e infraestructura y acelerar el avance científico».
Intel Xeon 7
Intel asegura que en cualquier sistema de supercomputación, la CPU sigue siendo el motor fundamental, desde la ejecución de aplicaciones científicas altamente paralelas hasta la orquestación de flujos de trabajo heterogéneos. Una promoción de la CPU frente a las aceleradoras GPU que proponen otros como NVIDIA, con novedades también presentadas en el SC26 como Rubin HPC.
La nueva generación de procesadores para servidores de Intel, conocidos por el nombre en clave Diamond Rapids, sucederá a la actual plataforma Xeon 6 y están diseñados como herramienta de procesamiento a escala empresarial. El Xeon 7 «Diamond Rapids» se basa esencialmente en la misma filosofía de desagregación que los AMD EPYC ‘Venice’ (ZEN 6) con los que competirá: los núcleos de la CPU se dividen en pequeños grupos de complejos de núcleos de CPU (CCX) contenidos en chips de núcleos de CPU (CCD), cuyos grupos interactúan con un chip de E/S de servidor centralizado (sIOD), que actúa como agente del sistema y centro de E/S.
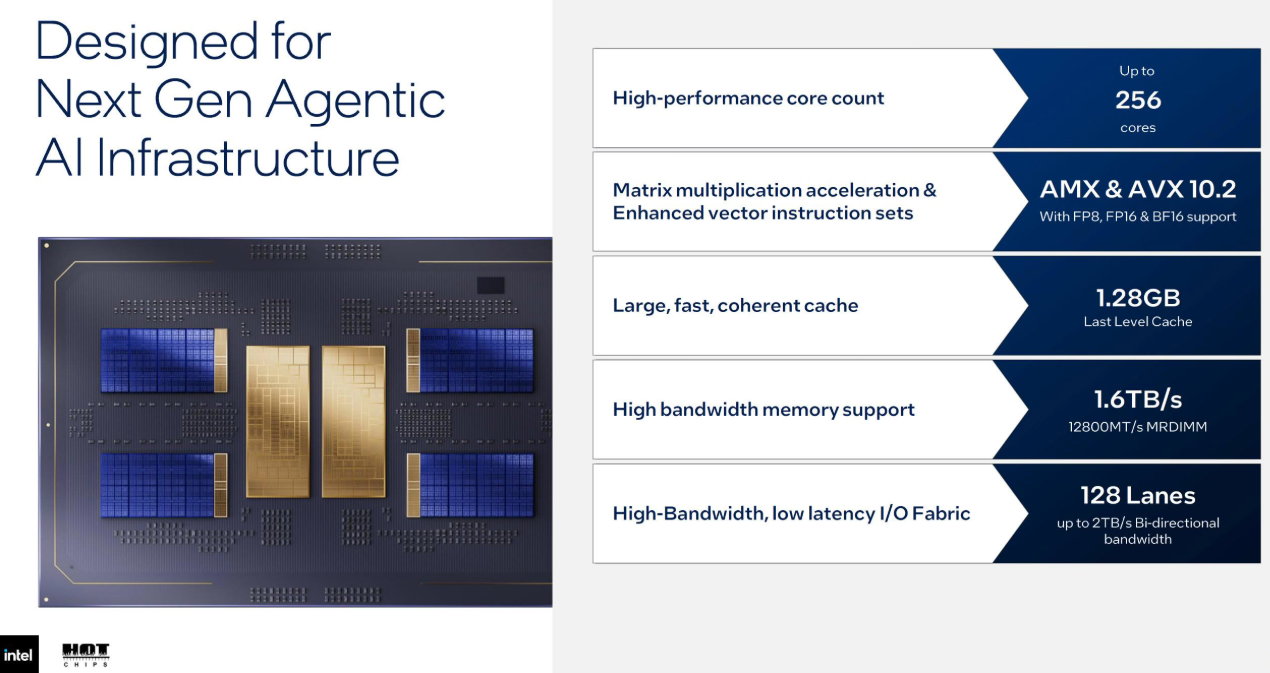
Los nuevos Xeon se comercializarán en configuraciones que ofrecerán hasta 256 núcleos de alto rendimiento, además de compatibilidad con las extensiones de rendimiento avanzadas (APX) de Intel, AVX 10.2 y las extensiones de matriz avanzadas (AMX) mejoradas. El chip también estrenará nuevas versiones de las interfaces E/S mas avanzadas, incluyendo PCI-Express Gen 6.
Los chips Xeon de próxima generación también ofrecerán un ancho de banda de memoria de hasta 1,6 TB/s y hasta 1,28 GB de caché de último nivel por socket. La placa base la que contiene una caché de último nivel (LLC) compartida entre los cuatro chiplets de núcleo. De esta manera, Intel ha logrado la agrupación de LLC entre 64 núcleos. Cada placa base cuenta con una enorme caché L3 de 320 MB compartida entre los cuatro chiplets de núcleo. Cada uno de los 16 núcleos en un chiplet de núcleo tiene acceso equitativo a la caché L3 de 320 MB ubicada en la placa base.
En cuanto a la fabricación, Intel aprovechará su nodo de fundición interno más reciente, el Intel 18A-P, para fabricar cada uno de los 16 chiplets de núcleo bajo este proceso tecnológico. Los módulos base que alojan estos chiplets se fabrican en el nodo de fundición Intel 3-T. Mientras tanto, los dos módulos Fabric Hub se fabrican en el nodo de fundición Intel 3. Por lo tanto, el procesador se fabricará completamente en nodos de fundición de Intel, sin dependencia de empresas externas.
GPU Intel serie D
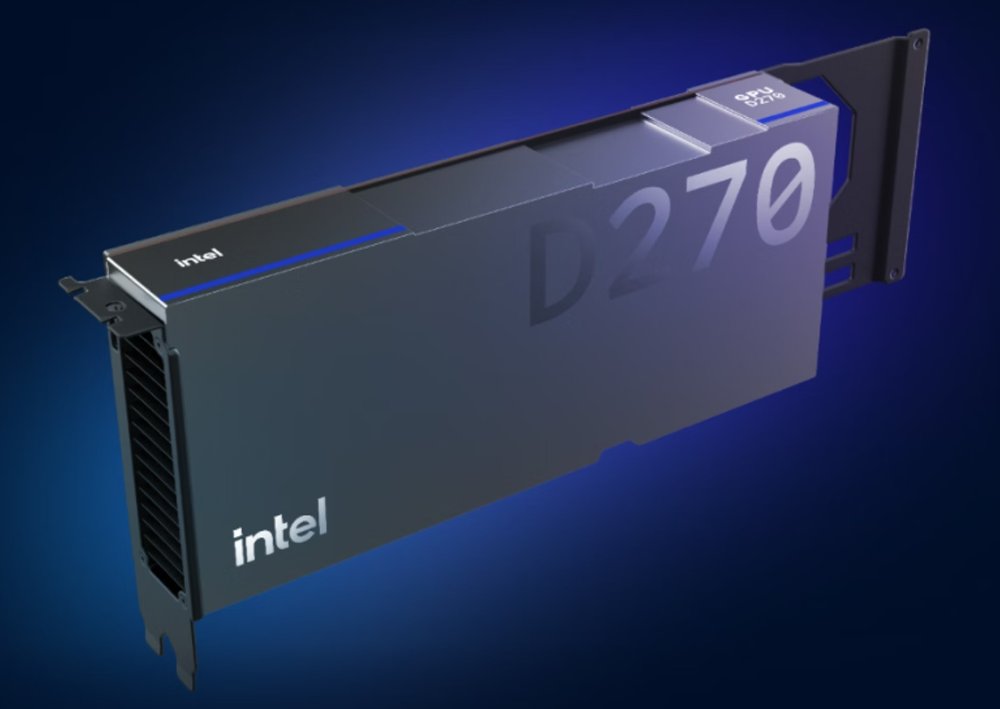
Teniendo en cuenta que la computación científica con IA a la que se dirige especialmente el nuevo hardware de Intel para HPC, el diseño de aceleradores debe equilibrar el rendimiento, la capacidad de memoria y la implementación práctica. La serie D de GPUs de Intel ofrece aceleración de IA y computación de doble precisión, compatibilidad con una amplia gama de tipos de datos, desde FP4 y MXFP4 hasta FP64, y hasta 480 GB de memoria LPDDR5X, todo ello en un diseño PCIe convencional con refrigeración por aire.
En entornos de investigación, la capacidad de memoria puede afectar directamente la eficiencia con la que se procesan grandes conjuntos de datos y modelos. Cuando los datos deben particionarse o transferirse repetidamente entre el host y el acelerador, la sobrecarga adicional puede ralentizar los flujos de trabajo científicos. Mantener los conjuntos de datos de trabajo más grandes en el dispositivo puede ayudar a reducir esa transferencia y permitir que el acelerador dedique más tiempo a tareas útiles. Esto brinda a los laboratorios la oportunidad de integrar agentes de IA persistentes y siempre activos en sus flujos de trabajo científicos existentes, lo que permite a los investigadores generar código, coordinar herramientas e iniciar tareas de computación en simulación, modelado y análisis de datos.
La serie D de Intel está diseñada para ofrecer a las instituciones eficiencia de inferencia en tiempo real y capacidad de memoria para acelerar estos flujos de trabajo y mantener más cargas de trabajo de IA ejecutándose en el dispositivo. En cuanto a rendimiento, Intel asegura que su GPU D270 ‘Crescent Island’ supera hasta en casi seis veces a la NVIDIA RTX PRO 6000 (versión Blackwell Server) en algunas cargas de trabajo en FP64 nativo. Intel comercializará versiones que van desde versiones base con 350 W de potencia con refrigeración por aire hasta versiones con doble GPU y refrigeración líquida.
Arquitecturas abiertas
La innovación en hardware pierde su valor práctico si introduce fricciones en el software, obligando a los equipos de desarrollo a utilizar ecosistemas propietarios que restringen la portabilidad del código, explica Intel al reiterar su compromiso con las herramientas de desarrollo abiertas y los ecosistemas HPC existentes.
Por ello, el enfoque de software de Intel se centra en una pila abierta única diseñada para dar soporte a la infraestructura existente tanto en cargas de trabajo de HPC tradicionales como en las emergentes de IA. El objetivo es garantizar que los desarrolladores puedan seguir utilizando los compiladores, las bibliotecas y los marcos de trabajo en los que ya confían. La inversión sostenida en Intel MPI, Fortran, optimizaciones de compiladores y oneAPI está dirigida directamente a mantener el rendimiento eficiente de las bases de código paralelas existentes en hardware moderno y heterogéneo.
Este enfoque pragmático se extiende a la preparación inmediata, garantizando que el software funcione sin problemas al implementar nuevo hardware. Para arquitecturas como la serie D de GPU de Intel, esto significa habilitar la ejecución inmediata de modelos y herramientas estándar. Al centrar los esfuerzos de ingeniería en la integración con marcos de IA, entornos de ejecución de inferencia y entornos de implementación estándar de la industria, tanto en CPU como en GPU, el objetivo es permitir que los equipos transiten a flujos de trabajo híbridos de IA-HPC sin sacrificar la portabilidad del código ni quedar atados a la hoja de ruta propietaria de un solo proveedor. Otro «toque» a NVIDIA que como hemos avanzado también está presentando sus nuevas soluciones para HPC en el evento de supercomputación que se celebra en Chicago.






Intel avanza sus próximas soluciones para HPC en la conferencia SC26

NVIDIA presenta Rubin HPC, su aceleradora más potente para ciencia e ingeniería

Nutanix promociona a Sven Schoenaerts como vicepresidente de Canal y Alianzas Tecnológicas para EMEA

Microsoft explica los motivos de la caída global de Outlook, Teams y Copilot de la semana pasada

La Junta de Castilla-La Mancha y WordPress.com pondrán herramientas profesionales de creación web al alcance de 45.000 estudiantes

CUDA y el precio de cambiar

50 años de EMACS, el editor que dio origen al software libre

«Con la IA, lo más complicado suele ser la gestión del cambio en la organización»

ONLYOFFICE renueva su alternativa a Microsoft Office y Google Docs para empresas

Tres de cada cuatro directivos españoles encuestados prevén gastar más en ciberseguridad en 2027, con la IA como prioridad

El revés de los centros de datos en las elecciones de EE.UU.: qué puede cambiar para la industria y para España

Esade e IBM proponen un modelo de resiliencia para gestionar la dependencia tecnológica desde el consejo
Intel avanza sus próximas soluciones para HPC en la conferencia SC26

Dell subirá los precios de sus monitores de gama media y alta

Proofpoint compra Varonis para crear un gigante de la ciberseguridad en la era de la IA

BSC AI Factory lanza un primer programa de aceleración para 100 startups españolas de IA

Orange, Telefónica, Vodafone y Deutsche Telekom se unen para competir con Starlink

Salesforce invertirá 1.000 millones de dólares en España para acelerar la IA agéntica
-
 A FondoHace 7 días
¿Quién podría ocupar el sitio de NVIDIA si todo fuera horriblemente mal?
-
 A FondoHace 7 días
AMD EPYC «Venice» a fondo: Zen 6, hasta 256 núcleos y una nueva generación de servidores
-
 A FondoHace 7 días
AMD MEXT: cómo ampliar la memoria RAM con IA y flash
-
 A FondoHace 7 días
Synology FlashStation FS200T, análisis